S
État potentiel structuré
Une trace x ouvre un espace structuré déclaré 𝓜ₓ d'actualisations possibles et induit un potentiel structuré explicite 𝒫₀ sur cet espace. Une représentation cachée arbitraire ne suffit pas.
Notre thèse est que l'intelligence ne devrait pas être réduite à une application directe de l'entrée vers la sortie, ni à la manipulation de représentations dont la structure potentielle reste implicite, mais être comprise comme un processus d'actualisation contextuelle : la transformation de significations possibles en actualisations différentiellement stabilisées sous des contraintes contextuelles.
Cette intuition s'inscrit directement dans l'approche dynamique de la polysémie développée par Bernard Victorri et Catherine Fuchs, puis étendue notamment par Fabienne Venant dans La construction du sens : un système complexe dynamique (2007). Dans cette approche, le sens linguistique est traité comme un continuum et les significations sont représentées non comme des points isolés, mais comme des régions.
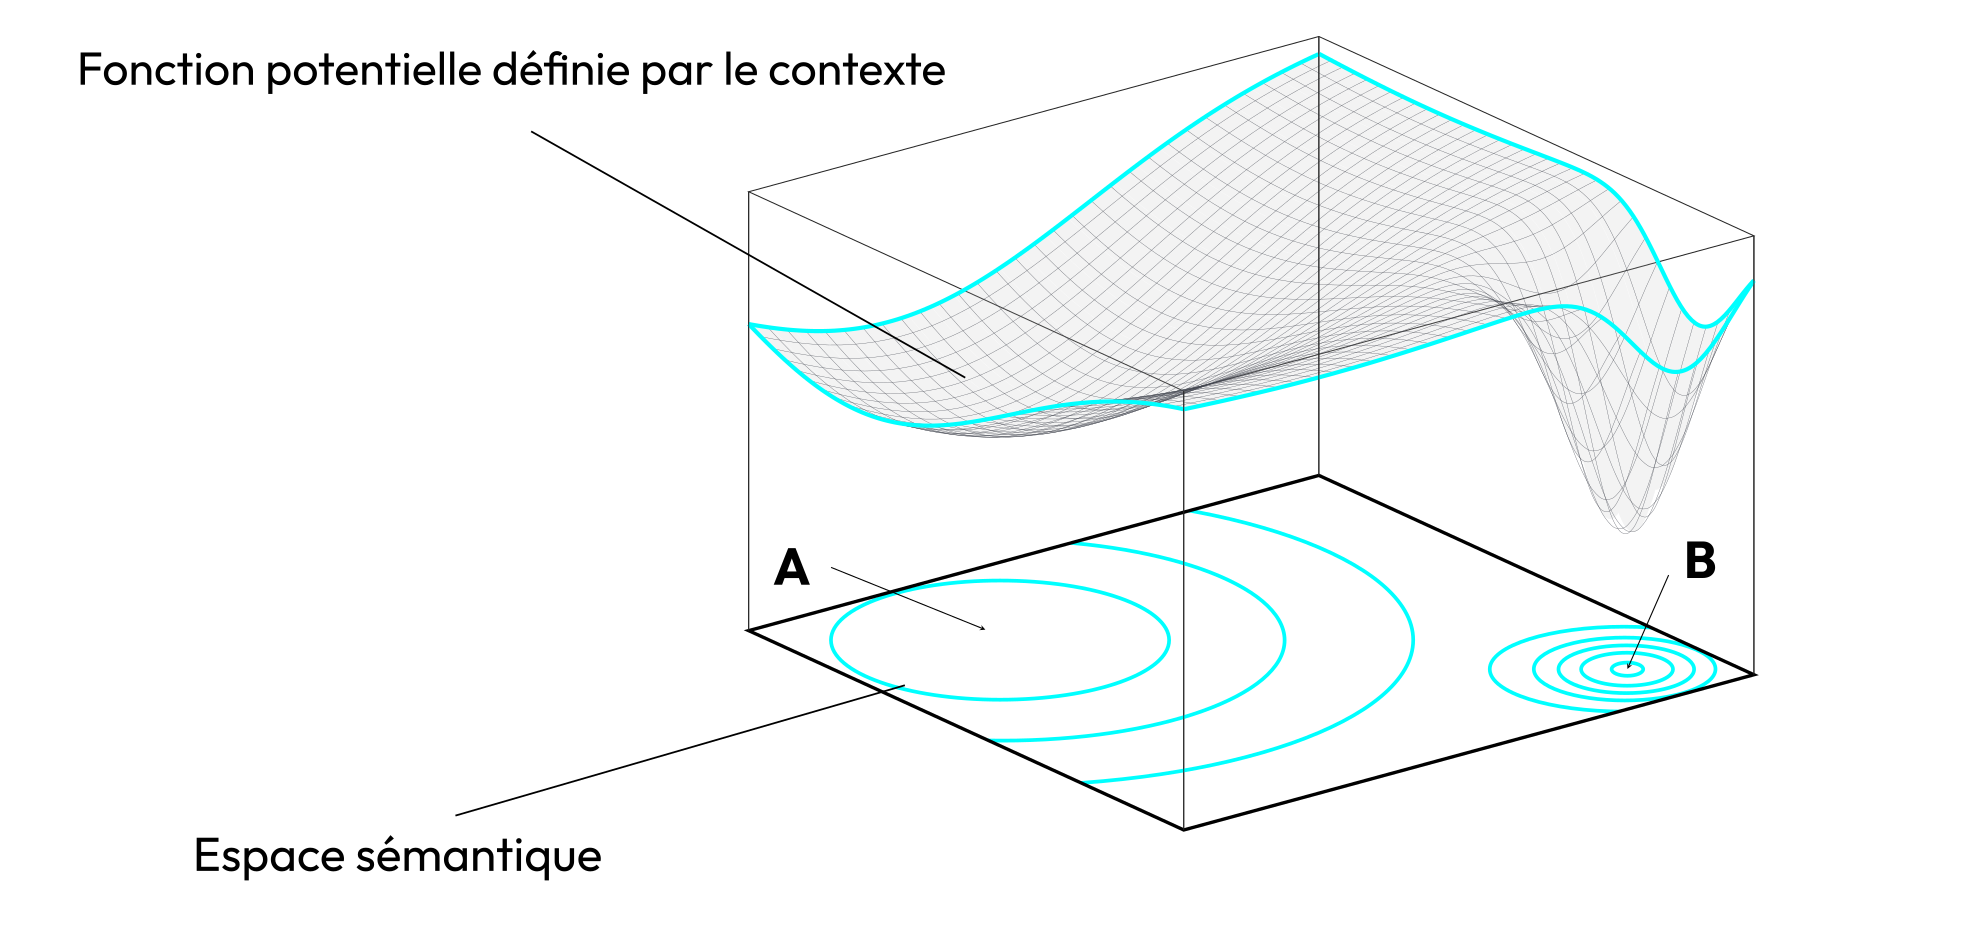
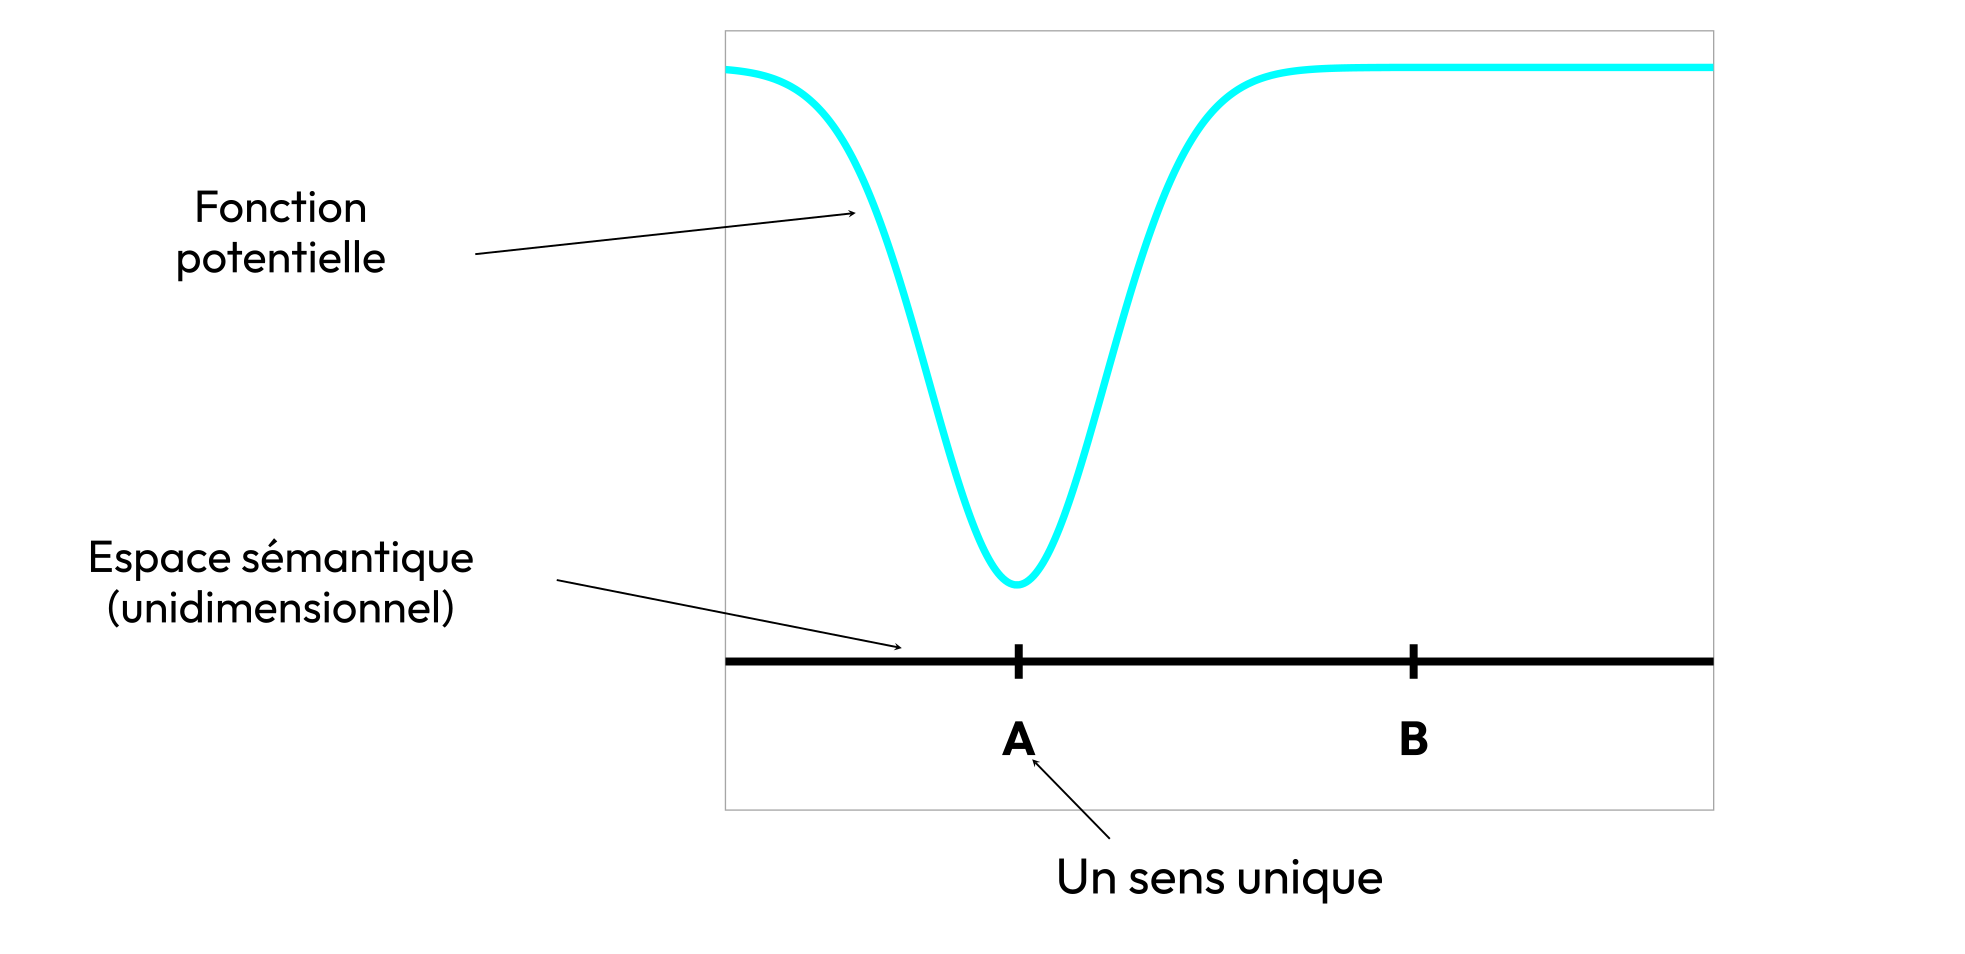
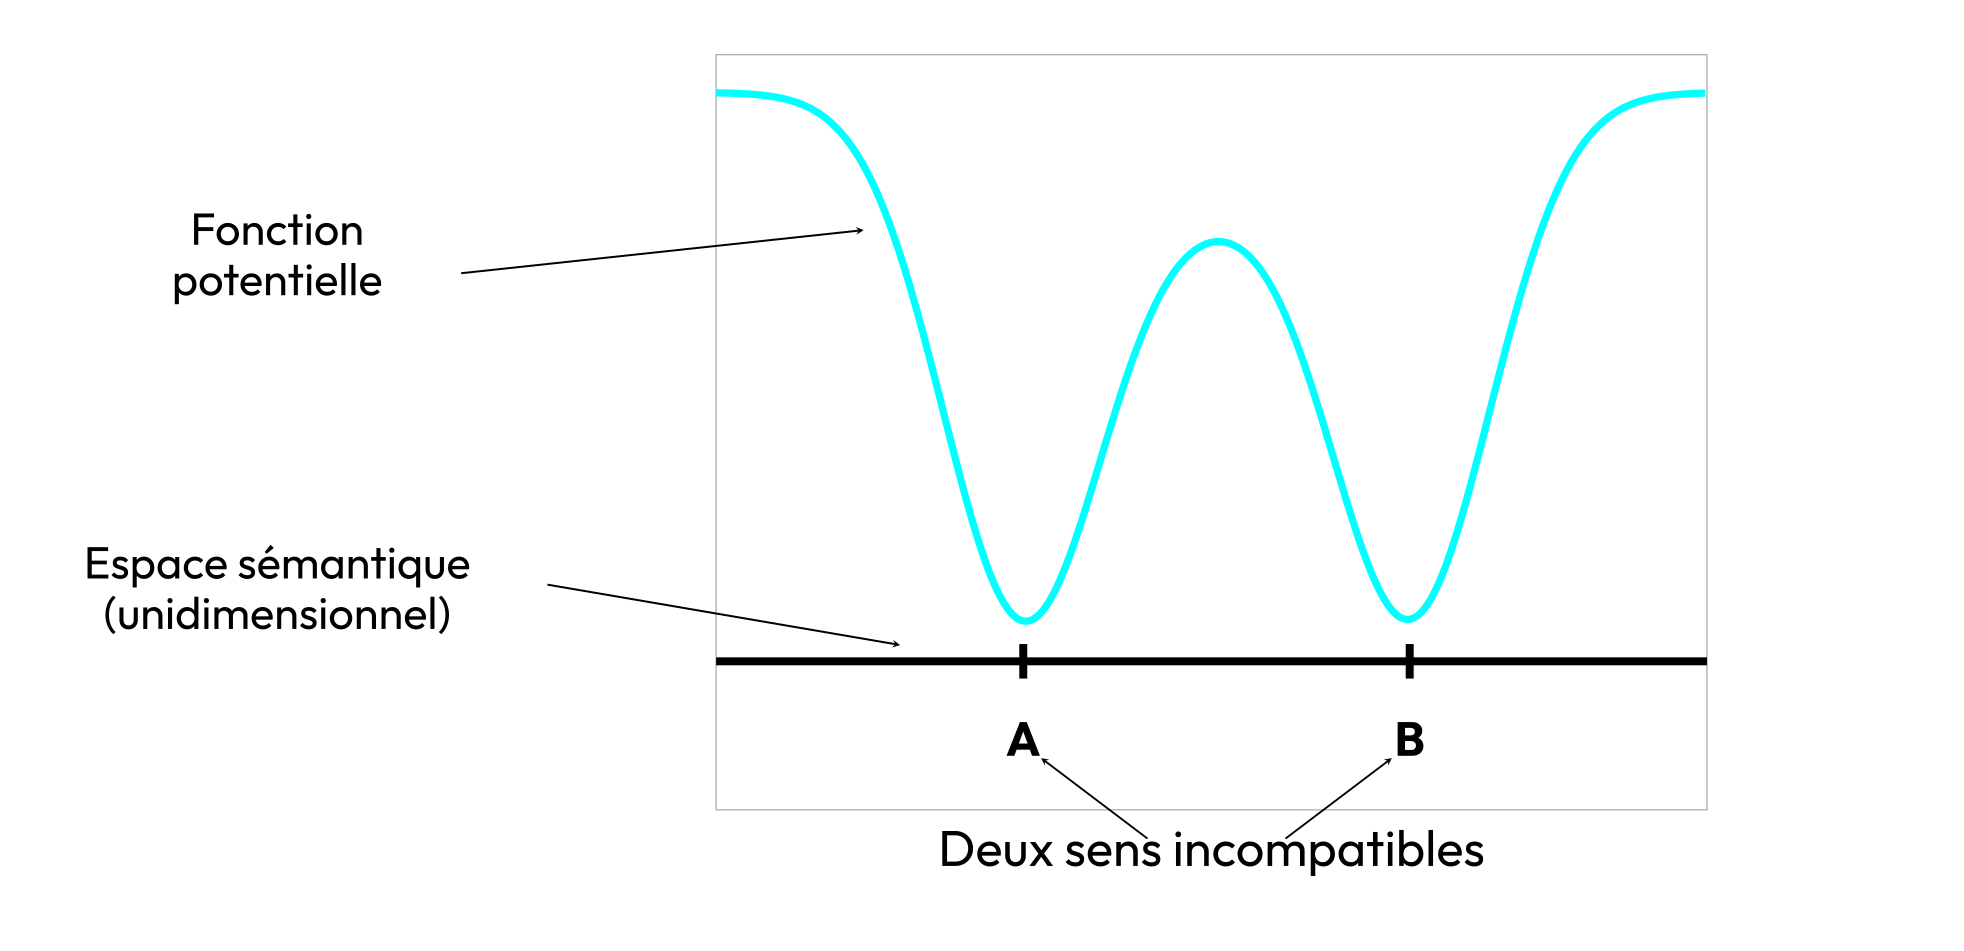
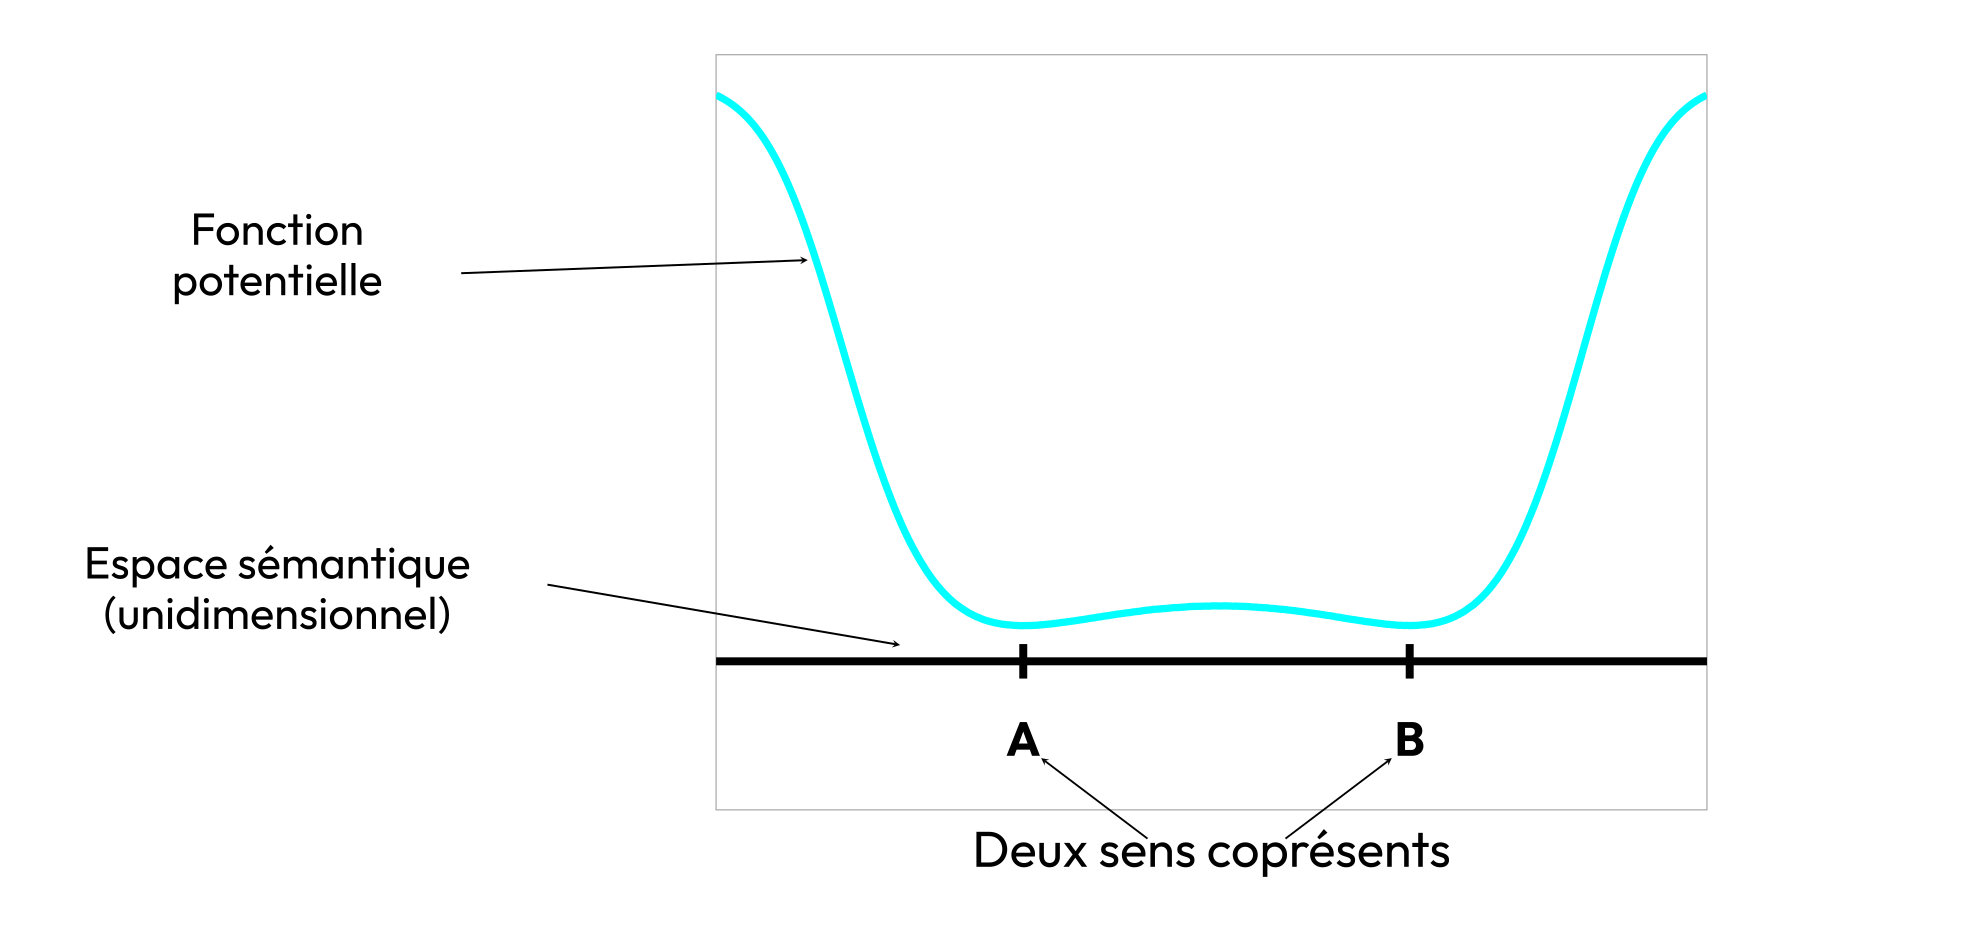
Trois cas peuvent apparaître dans la construction du sens des mots et des expressions linguistiques : le sens précis, l'ambiguïté ou l'indétermination.
La géométrie du potentiel sémantique contient un bassin dominant étroit.
Plusieurs bassins étroits restent fortement pondérés.
Le potentiel sémantique est unique et large.
Le malentendu, dans la communication non verbale comme verbale, reste donc toujours possible. Lorsqu'un locuteur produit une trace, l'auditeur en construit une interprétation depuis une histoire contextuelle située qui lui est propre. Les deux constructions peuvent se recouvrir suffisamment pour permettre la communication, diverger légèrement, ou se séparer au point de produire un malentendu.
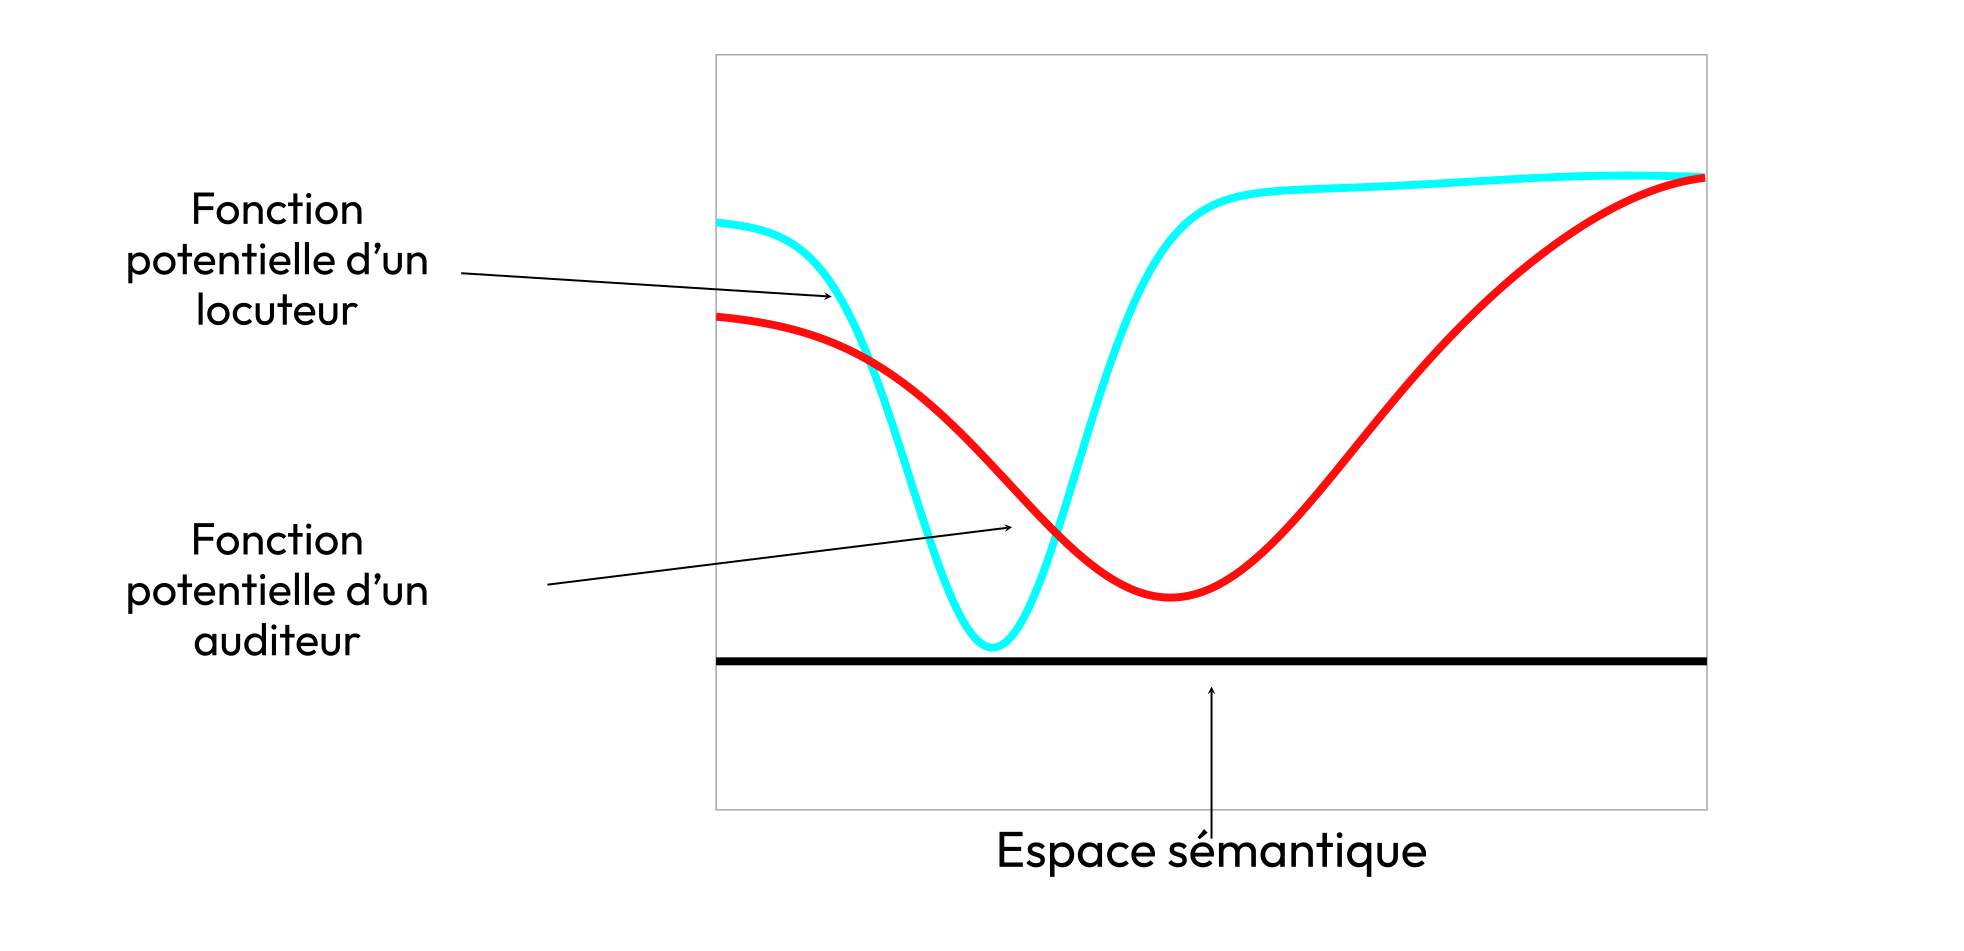
Cette typologie est l'un des ancêtres conceptuels les plus directs de GPM.
Un système est un Geometric Potential Model si et seulement si trois conditions sont conjointement satisfaites :
Une trace x ouvre un espace structuré déclaré 𝓜ₓ d'actualisations possibles et induit un potentiel structuré explicite 𝒫₀ sur cet espace. Une représentation cachée arbitraire ne suffit pas.
Le contexte transforme causalement le potentiel par une voie déclarée.
L'actualisation dépend causalement de 𝒫_C. Si le potentiel peut être contourné, détruit ou remplacé sans modifier systématiquement le comportement, le système n'est pas un GPM.
Un système qui échoue à satisfaire l'une de ces trois conditions n'est pas un GPM, quel que soit le vocabulaire employé pour le décrire.
La première différence majeure concerne le mécanisme principal du calcul contextuel. Les LLMs contemporains sont organisés autour de l'attention : les représentations de tokens interrogent, pondèrent et agrègent d'autres représentations de tokens. Un GPM est organisé autour de l'actualisation : le contexte déforme un potentiel structuré explicite, et la sortie est lue depuis le champ qui en résulte.
Une structure géométrique existe déjà dans les réseaux neuronaux conventionnels. GPM lui donne un autre statut architectural : le potentiel courant devient un état explicite, façonné par le contexte et causalement nécessaire à l'actualisation. Les paramètres appris définissent comment cet état est construit. Le potentiel lui-même décrit le paysage actuel des actualisations possibles.
Représentations latentes: une structure géométrique peut émerger dans les activations
Quelle structure le réseau a-t-il apprise dans son espace de représentation ?
Potentiel géométrique: sa morphologie constitue un état causal de l'actualisation
Comment l'espace des actualisations possibles est-il structuré et déformé par le contexte ?
Les LLMs sont principalement entraînés à produire une distribution sur les continuations. Dans un GPM, la probabilité peut représenter le potentiel ou servir à sa lecture, et un modèle probabiliste latent suffisamment riche peut encoder différents états potentiels. La structure potentielle qui joue un rôle de médiation causale reste explicitement identifiable tout au long du processus.
est principalement entraîné à produire une distribution sur les continuations
Quelle probabilité attribuer aux différentes sorties ?
exige qu'une géométrie potentielle explicite joue un rôle causal dans l'actualisation
Quelle est la morphologie des possibilités dont cette distribution est issue ?
Deux états potentiels différents peuvent mener à la même probabilité de sortie. Par exemple, une ambiguïté entre deux possibilités bien distinctes et une indétermination diffuse peuvent toutes deux produire une répartition à 50/50. Pourtant, lorsqu'un nouveau contexte intervient, elles n'évoluent pas de la même manière. La seule probabilité de sortie ne permet donc pas de les distinguer. Un GPM cherche à préserver cette différence afin qu'elle reste explicite, causalement active et vérifiable.
Avec des poids figés et une chaîne entièrement fonctionnelle sans sampling, un GPM est déterministe à l'inférence : la même entrée suit la même trajectoire interne et produit le même résultat. À l'inverse, les produits fondés sur des LLMs utilisent couramment un décodage stochastique, qui peut générer différentes continuations pour un même prompt.
échantillonne couramment une distribution du prochain token
Un même prompt peut produire une continuation différente
suit une trajectoire d'état reproductible lorsque l'inférence et le décodage sont fixés
Même version du modèle + même entrée → même résultat
La reproductibilité devient un contrat d'exécution. À version du modèle, runtime, état initial et politique de décodage fixés, la trajectoire complète — du premier état potentiel à la lecture finale — peut être rejouée étape par étape.
GPM organise l'inférence autour d'une géométrie potentielle explicite. Le contexte déforme cette géométrie, le système se stabilise dans un état structuré, puis l'actualisation est lue depuis cet état au sein d'une chaîne causale déclarée. Les blocs Transformer et les routages dérivés de l'attention n'interviennent pas dans ce processus.
Trois questions permettent de lire plus clairement ce paysage. L'architecture contient-elle une self-attention softmax classique ? Repose-t-elle sur une mémoire associative K/V avec une lecture de type Q ? Son mécanisme descend-il architecturalement de l'attention ? Des dualités mathématiques peuvent relier différents opérateurs tandis que leurs chaînes de calcul restent fondamentalement distinctes.